Avatar 形象能否提升用户对 AI 数字人的共情感知
以受控 A/B 测试检验 Avatar 形象对用户感知共情的真实影响,为对话式 AI 的形态投入提供实证依据。
- AI 数字人研究项目
- 时间
- 2025.5 – 2025.12
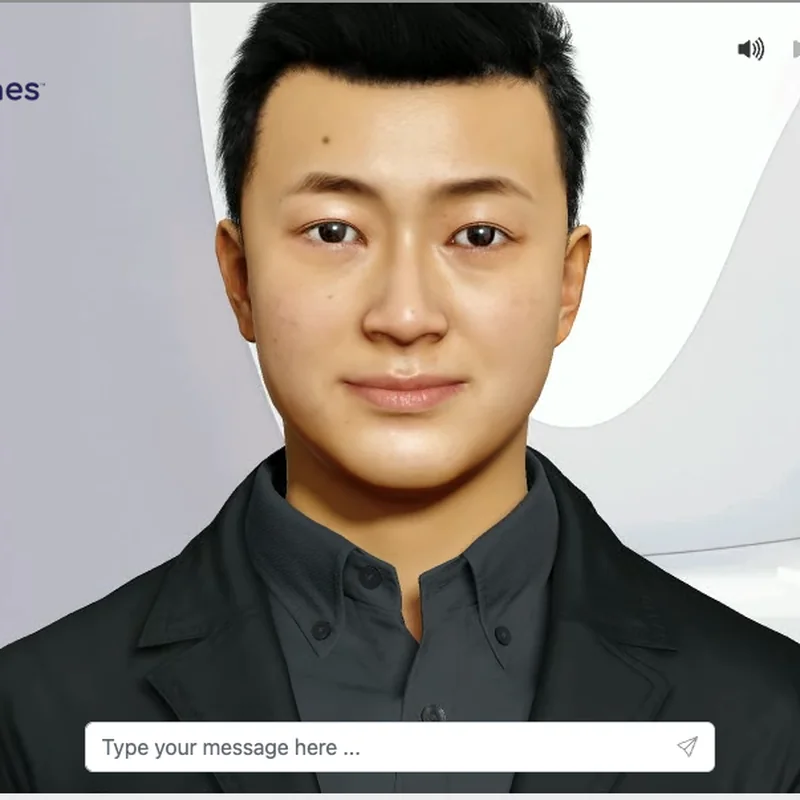
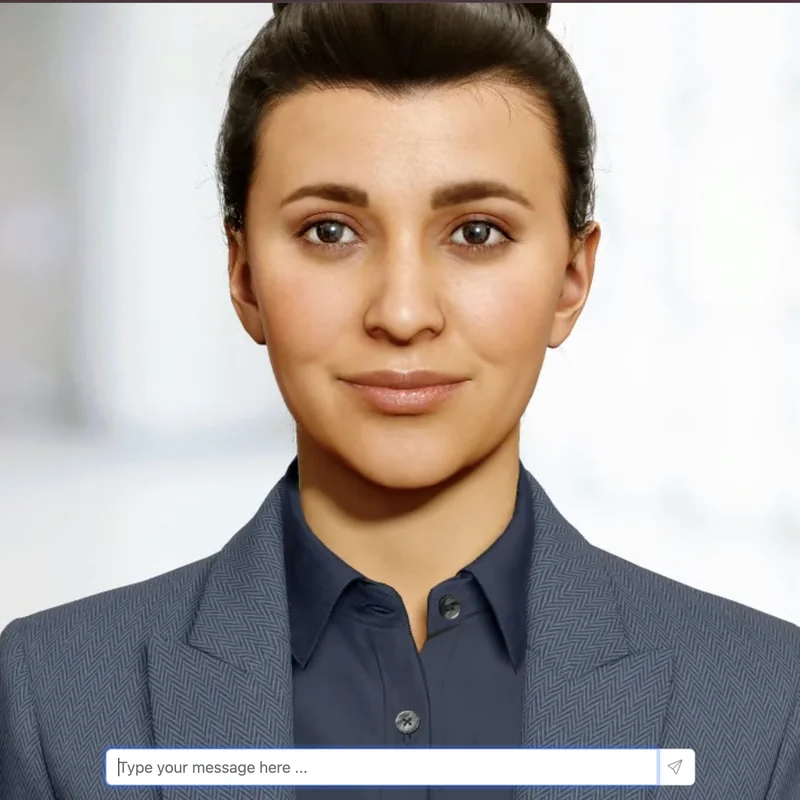
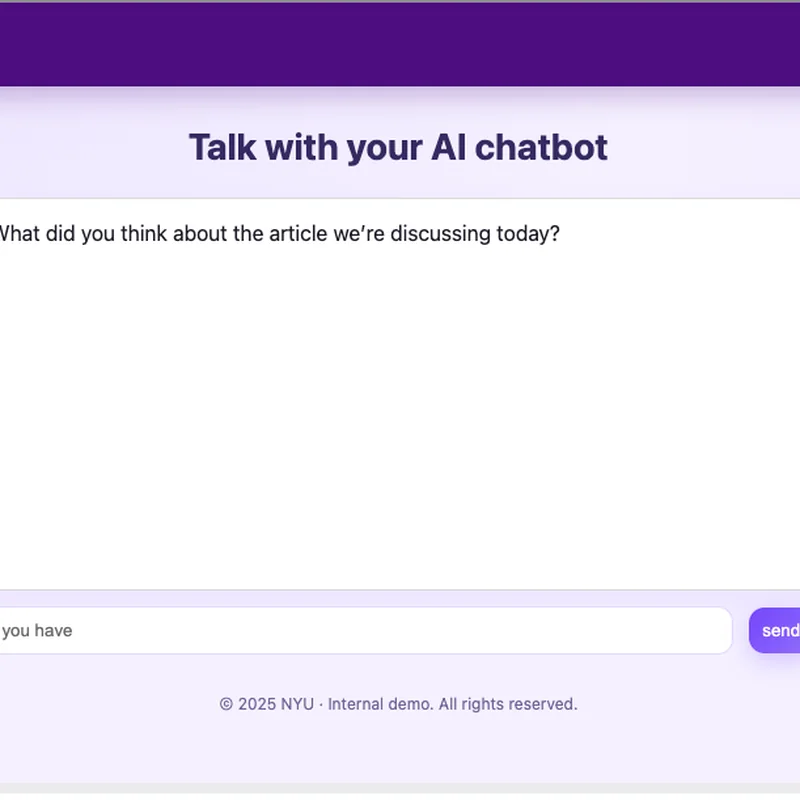
Avatar 组(男性与女性两种形象)与 Text 组的实际界面。三者接入同一个后端、同一个模型、同一段人设提示词, 差异仅在于界面形态,因此体验上的差异只能归因于形态本身。
- A/B 测试 Avatar 与 Text 两组条件
- 186 段真实人机对话
- CHI 2026 BiAlign Workshop 录用
01 背景与问题
对话式 AI 领域有一个鲜少被质疑的共识:为 AI 配上会说话、有表情的 3D Avatar 形象,用户会认为它更温暖、更具理解力。这个假设对应着明确的成本——数字人平台的授权费、动画与语音的调优、渲染带来的算力开销。在心理健康、陪伴、医疗问诊这类情感敏感的场景中,不少团队将这笔投入视为默认选项。
但在已有研究中,这一变量几乎从未被单独检验。以往的对比里,Avatar 版与文字版往往在模型、提示词与话术上同时存在差异,“Avatar 让人感觉更温暖”因此完全可能只是”那一版的文案写得更好”。
我们把它还原成一个产品问题:这笔投入是否成立。要回答它,必须把界面形态从模型、提示词与对话内容中剥离出来,单独对照。
02 A/B 测试设计
实验分 Avatar 与 Text 两组,被试随机进入其一。Avatar 组内部再分男性与女性两种形象,用以排除结果由单一形象的外观偏好造成。
两组之间保持完全一致的部分:
| 模型 | GPT-4.1-nano,temperature 0.7 |
| 人设提示词 | 同一段 system prompt,一字不改 |
| 对话素材 | 同一个 25 篇负面共情新闻的文章池 |
| 会话逻辑 | 同一套上下文构建、轮次计数、完成码规则 |
| 数据结构 | MongoDB 里同一套 document schema |
实验约束直接写入 prompt。人设提示词包含三条硬性规则:每次回复不超过两句、不得承认自己是 AI、满 10 轮之前不发放完成码。三条分别对应三个目的——控制信息量不随形态变化、避免被试在知晓对方身份后改变评价标准、保证每段对话具备可供分析的长度。
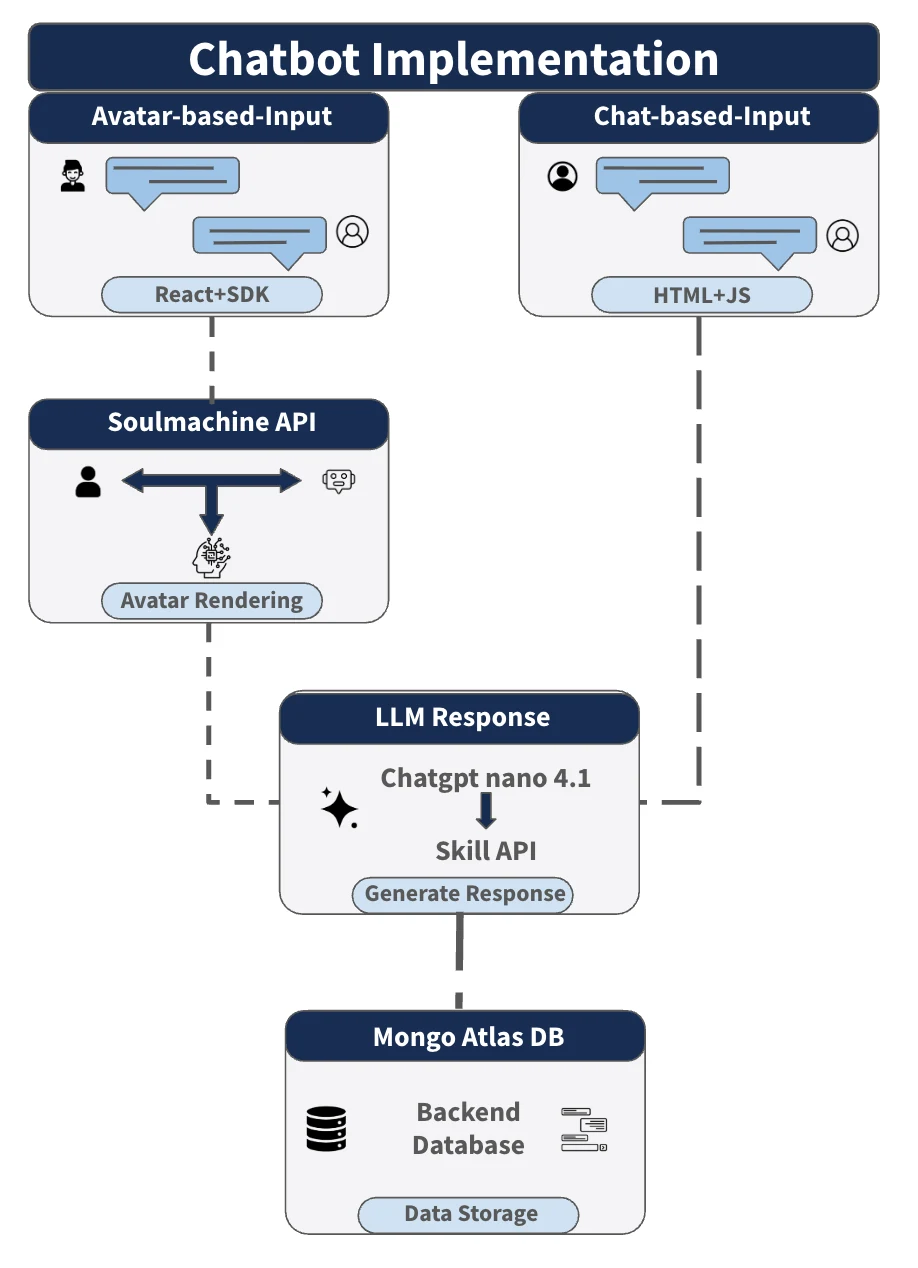
技术: Avatar 一侧以 Skill 的形式接入 Soul Machines 平台,由平台在交互时回调后端;文字一侧是直连 OpenAI 的 FastAPI 服务。两者的会话处理逻辑保持一致。
03 两套产品:形态不同,后端相同
Avatar 前端基于 React 与 Soul Machines Digital Person SDK,初始化时建立 WebSocket 与平台双向串流音视频,支持语音输入(走平台的 STT)与文字输入兜底,形象实时渲染,口型与语音同步。
文字前端是一个极简单页,仅含对话区、输入框与发送键,不引入组件层级与状态管理框架。
两端共用同一套后端逻辑:由 URL 参数识别被试与其所读文章,将文章内容与人设提示词一并构成对话上下文,逐轮维护历史、调用同一模型生成回复,并以同一套结构写入 MongoDB。差异只存在于前端形态,后端的处理路径完全一致。
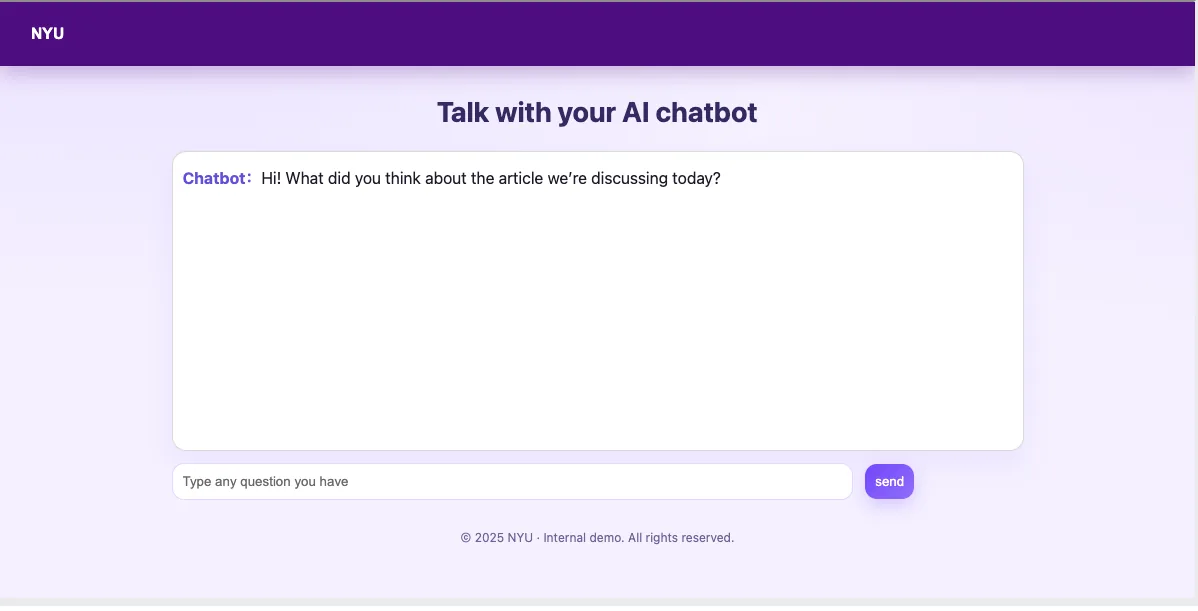
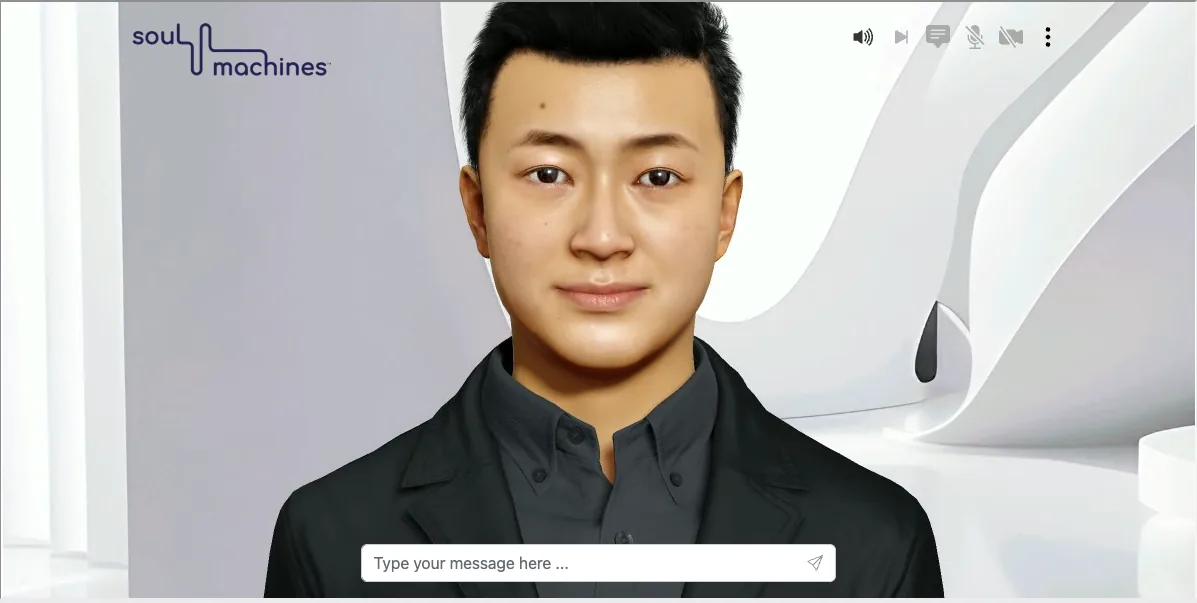
两套产品均经 Nginx 对外,以 iframe 嵌入 Qualtrics 问卷,被试全程在问卷内完成对话。被试从 Prolific 招募(美国、英语母语、18 岁以上、桌面端且具备摄像头与麦克风),报酬 $2。
04 把共情变成可测量的指标
共情是主观感受,没有现成的刻度。我们没有自建量表,而是把每一道题对应到心理学中已被验证的工具上,以保证测量效度。共用到三套:
- SPUR 社会临场感量表 — 对话后测的主体,按三个维度展开:感知会话质量(PCQ),覆盖流畅度、语法语义、话题相关与推进、情绪理解、温暖度、个性化适应等 14 题;感知共情(EMP),测被试是否认为对方具有真诚的共情;信任(TRUST),测可信、亲和与真实感。
- Godspeed 量表 — 以语义差异形式测量拟人度、活性、好感度、感知智能与感知安全五个维度。其中拟人度一维后续成为解释机制的关键。
- BFI-20 人格问卷 — 取自 IPIP 题库的 20 题简版大五人格,于对话前施测,用于在回归中控制个体差异,重点是外向性与宜人性。
被试动线如下:
| 环节 | 内容 |
|---|---|
| 筛选与同意 | Prolific 定向投放 → 知情同意书 → 自动抓取 Prolific ID |
| 前测 | BFI-20 人格问卷(20 题) |
| 刺激 | 阅读一篇负面共情新闻(文章池取自 WASSA 数据集,带 empathy / distress 标注) |
| 交互 | 随机进入 iframe 内的 Text / Avatar 窗口,按指示完成至少 10 轮对话,取回完成码 |
| 后测 | PCQ → EMP → TRUST → Godspeed 五组量表,均为 7 点 |
问卷设计遵循一条原则:题面采用被试能够直接理解的日常表述,背后对应成熟量表。“你认为对方是否具有真诚的共情”这样的问法便于自然作答,而它在数据上是 EMP 合成分的一项。
05 结果
有效样本 186 段对话(剔除未答满及少于 6 轮的记录),Text 93 段,男性 Avatar 49 段,女性 Avatar 44 段。
Text 组在三项指标上均高于 Avatar 组:
| 指标 | Text 组 | Avatar 组 | 检验 |
|---|---|---|---|
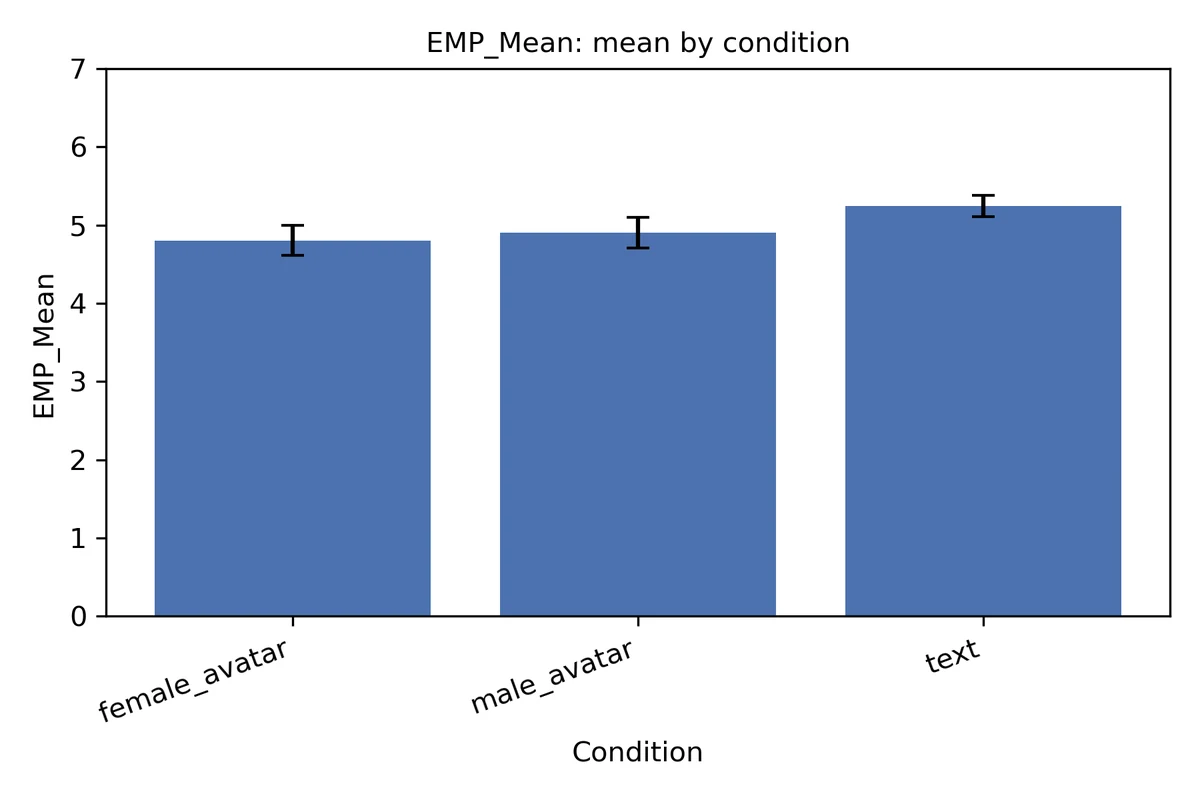
| 感知共情 EMP | 5.25 (SD 1.24) | 4.86 (SD 1.31) | t = −2.09, p = .038 |
| 会话质量 PCQ | 5.85 (SD 0.83) | 5.55 (SD 0.87) | t = −2.35, p = .020 |
| 信任 TRUST | 5.34 (SD 1.16) | 4.97 (SD 1.26) | t = −2.07, p = .039 |
差异并非源于样本构成:将人口学(性别、种族)、人格(外向性、宜人性)与对话总 token 数一并纳入 OLS 后,界面形态仍是显著的负向预测因子(β = −0.438, p = .018)。结果因此不能归因于 Avatar 组对话更短,或该组被试本身评价更严格。
两种 Avatar 形象的结果接近(男 4.91 / 女 4.80),可排除单一形象带来的偏差。
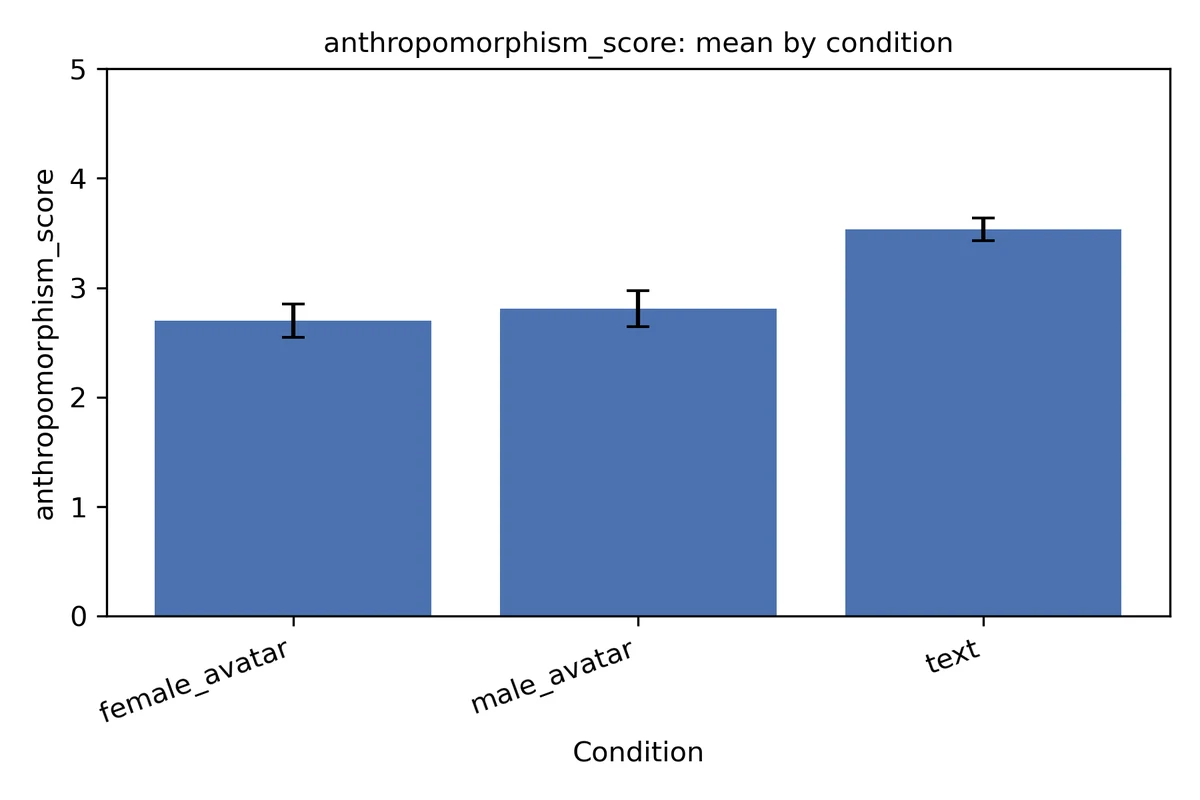
机制来自 Godspeed 的拟人度一维:被试认为纯文字的聊天机器人更像人(3.52 vs 2.76,t = −5.01,p < .001)。将拟人度纳入中介模型后,形态对共情的直接系数由负转正(β 从 −0.438 变为 +0.29, p = .029),说明 Avatar 对共情的负向影响完全经由拟人度传导。
期望违背理论(EVT)对此提供了解释:一张会动的人脸会同时抬高用户对表情、语调与交互节奏的预期,而当前的 Avatar 技术难以满足这些预期;落差出现后,用户会以更严格的标准评价同样的对话内容。纯文字界面不引发这类预期,也就不承担相应的落差。
06 差距来自语言,还是来自形象
这一结果存在一个需要排除的解释:Avatar 组的对话内容本身可能质量更低。若如此,结论便只反映了对话质量的差异,与具身无关。
为此,我们抛开界面,仅从对话文本估算共情,比较两组在语言层面的差距,用了两种相互独立的方法。
① 微调 Transformer,将共情建模为回归任务。 在 WASSA 2024 共享任务数据集上微调并横向对比五个模型——DeBERTa-v3、RoBERTa、BERT、DistilBERT、TinyBERT,输入为拼接说话人标记的多轮对话,输出连续的共情分数,最优为 DeBERTa(测试集 Pearson r = 0.4153, p < .05)。另设一组冻结骨干的基线作对照,确认提升来自微调而非模型先验;随后把训练好的模型用于本研究的对话,得到一个纯文本的共情估计。
② LLM-as-a-judge。 使用 GPT-4o 与 GPT-4.1 直接从文本打分。打分前移除全部身份字段,将双方标记为 “Person 1 / Person 2”,使模型无从判断哪一方是人、哪一方是机器人,亦不知晓所属实验条件;随后要求其按与被试问卷完全相同的题目,预测 Person 1 对 Person 2 的共情评分(1–7 分),各题取均值。
两种方法得到的结论一致:Avatar 组与 Text 组在文本层面的共情差异很小,且方向并不稳定;而被试自评的差异是显著的。两组说出的话在语言上共情程度相当,真正改变评价的是界面形态本身。「Avatar 组的对话质量更低」这一解释由此被排除,形态与共情之间的因果关系得以成立。
技术: 微调采用分层学习率(编码器 1e-5、逐层衰减 0.95,分类头 5e-5)、渐进解冻、梯度裁剪与早停,输入截断 512 token。
07 结论
视觉具身不会自动改善情感体验,它改变的是用户评价时所依据的标准——Avatar 抬高了预期,而当前技术尚不足以满足这些预期。对产品决策而言:在共情驱动的场景中,Avatar 应先经过验证再投入采购;若决定采用,决定成败的也不是外观保真度,而是口型同步、语音韵律、打断处理与响应时延这些直接关系到预期能否被满足的环节。
论文《When Embodiment Backfires: The Impact of AI Chatbot Avatars on Human Perceived Empathy》录用于 CHI 2026 BiAlign Workshop,同时公开了包含 186 段对话日志与配套量表应答的数据集。