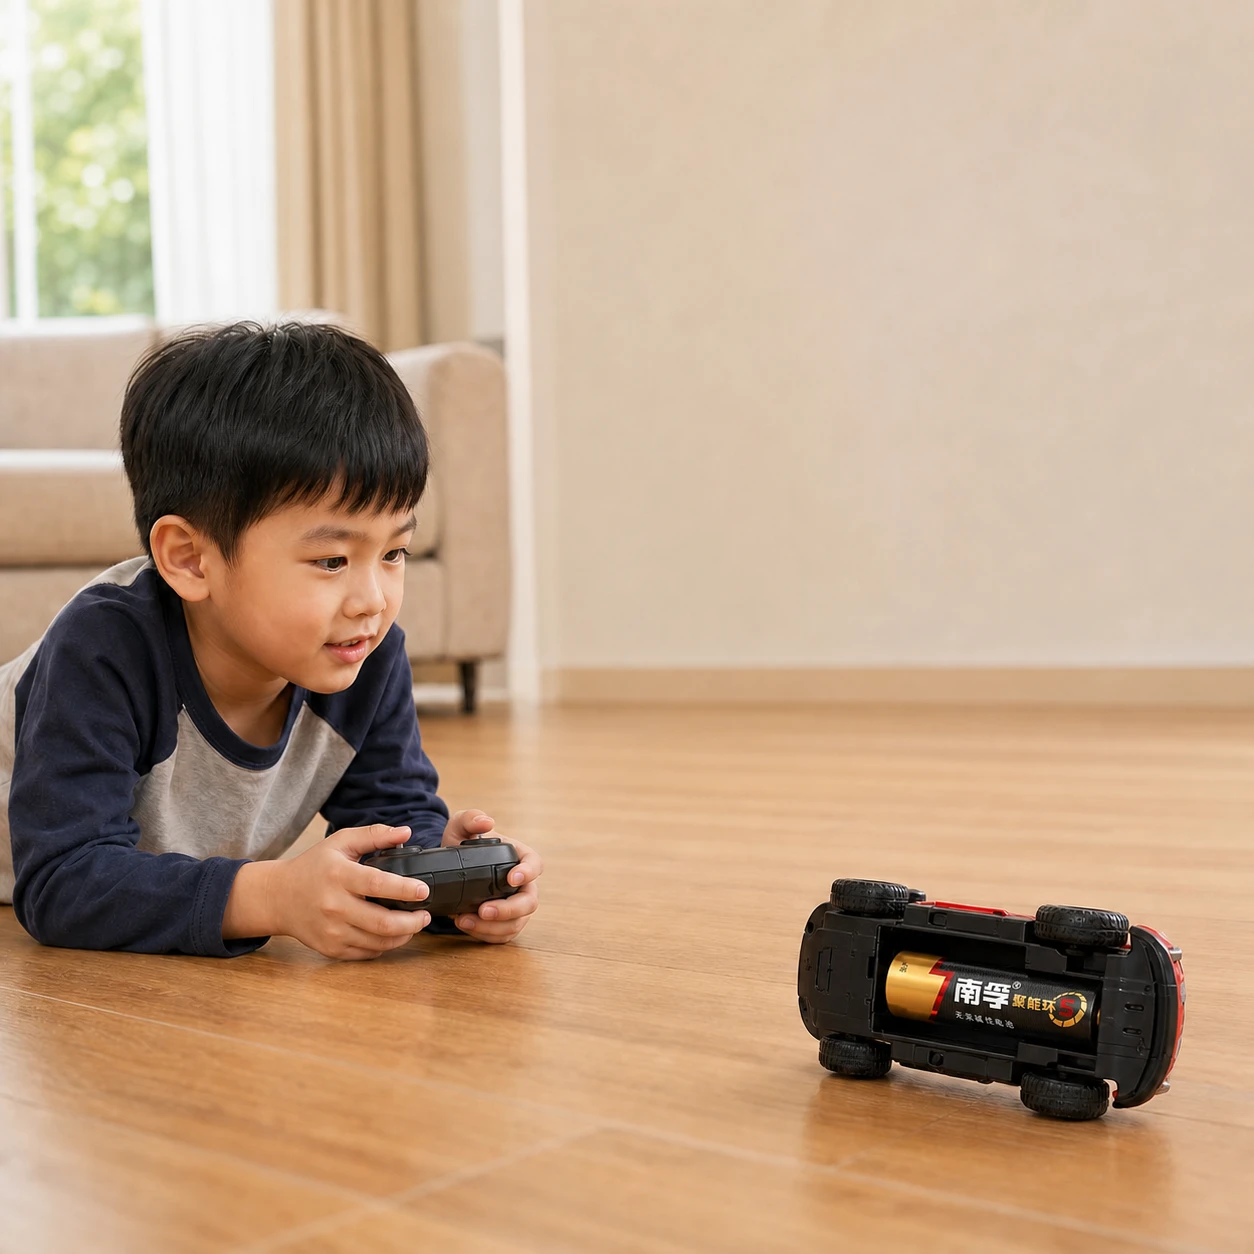
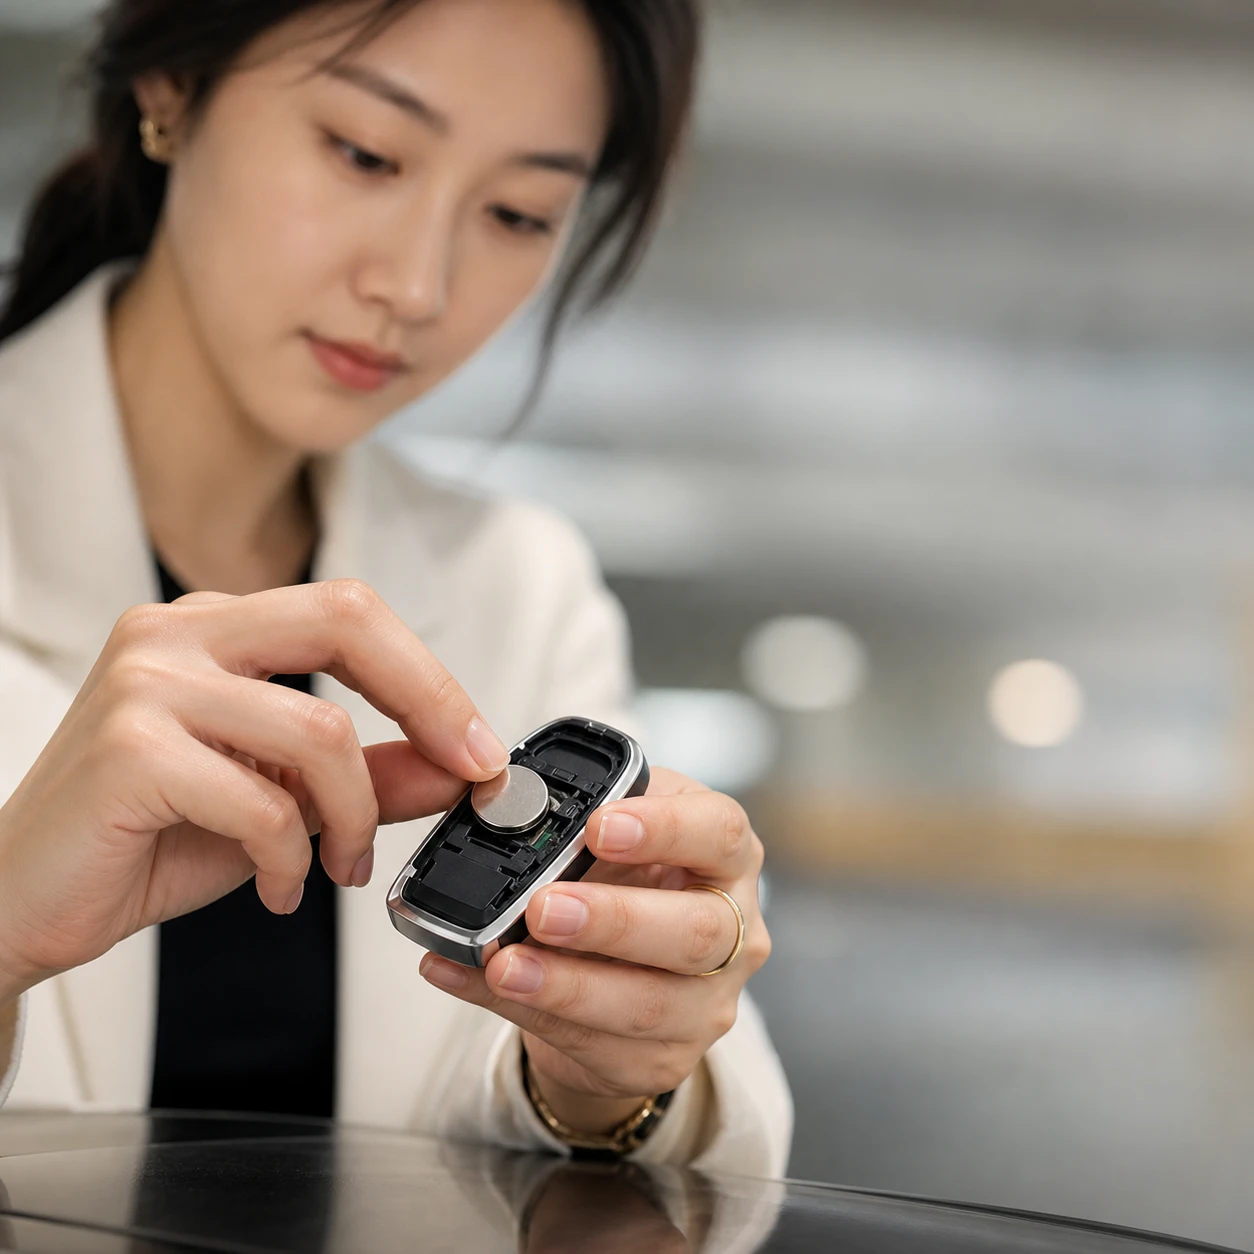
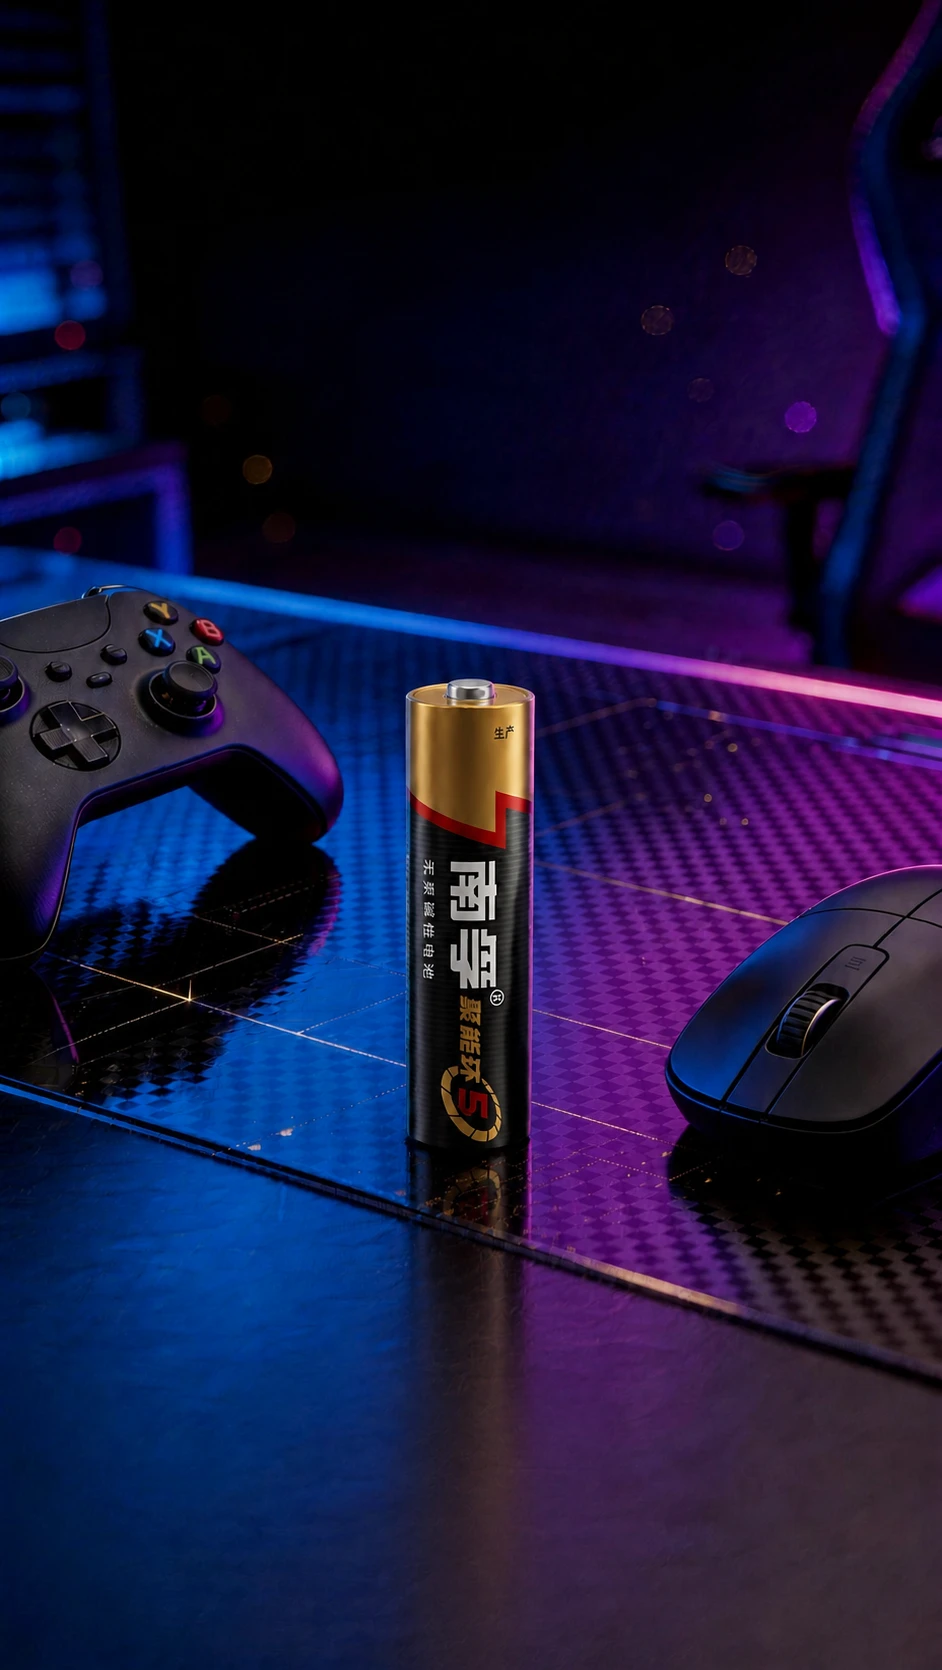
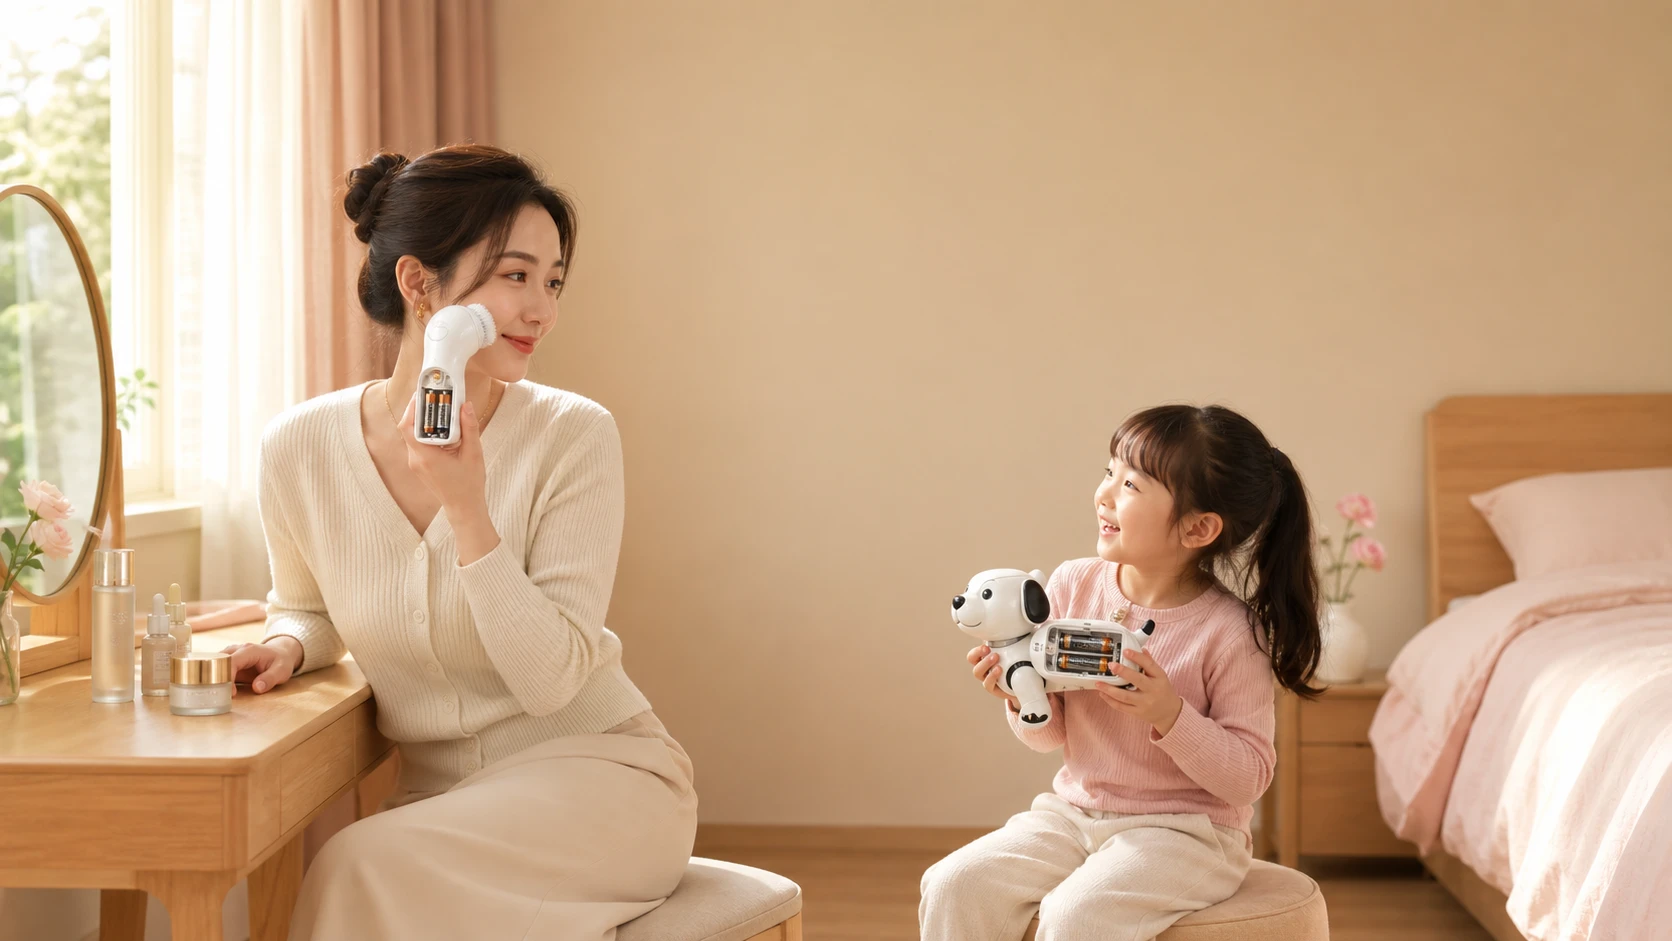
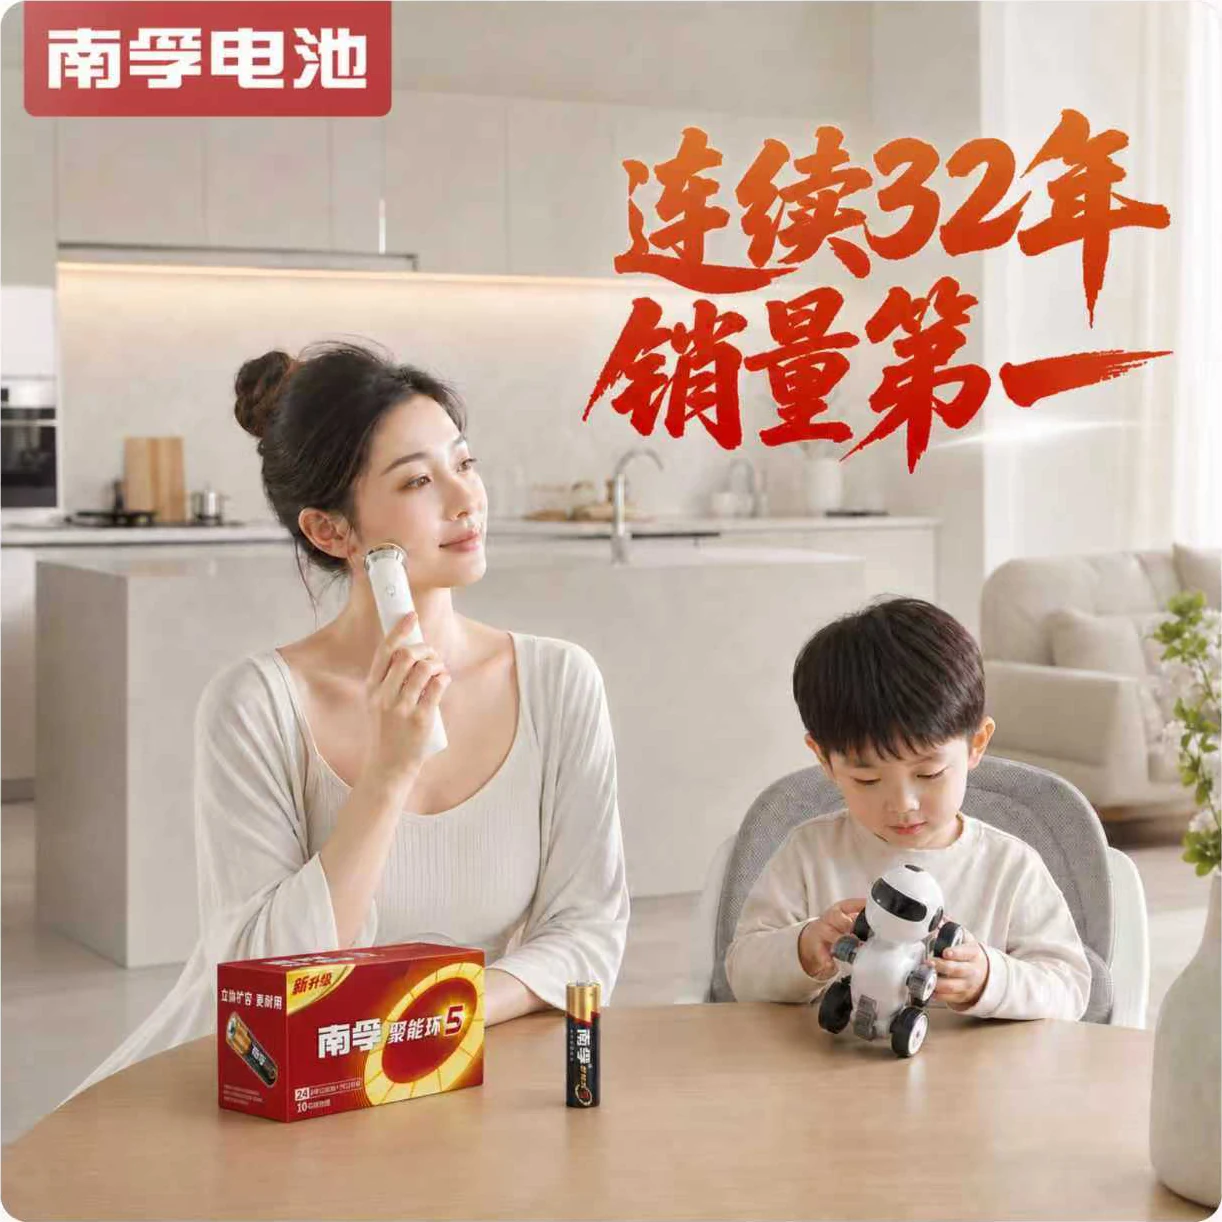
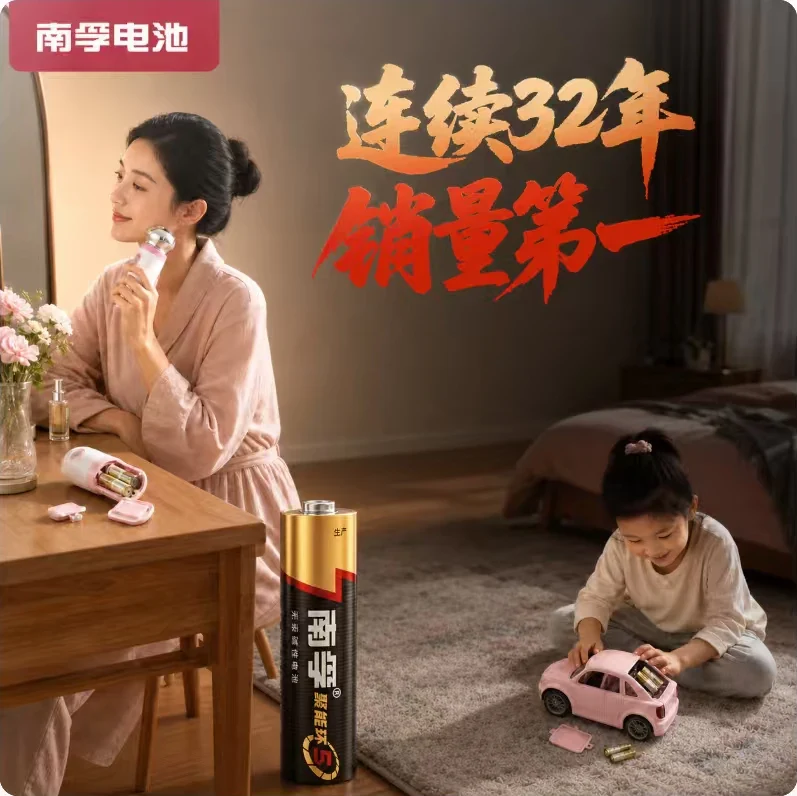
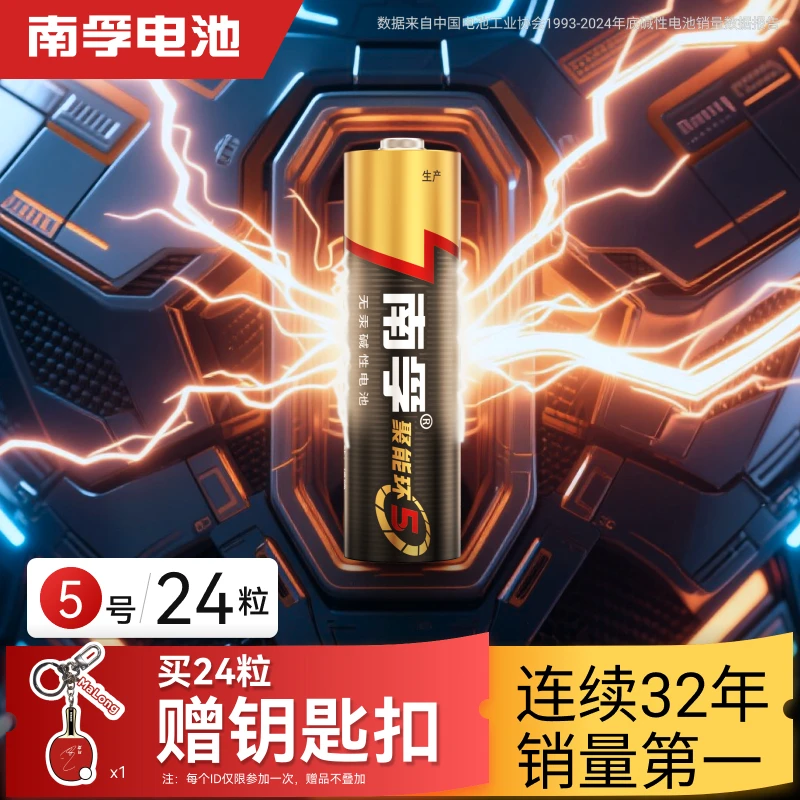
以上是 Agent 目前跑出来的部分 demo:前四张是生成的场景底图,后两张已完成品牌标识、卖点文案与电池、包装等组件的合成。 这些图再经过末端的微调精修,即可作为商用素材直接上线投放。
- 约 70% 素材生产由 Agent 承担
- 5 维 自动质检维度
- 2 套 品牌规则集与渠道 rubric
01 背景与问题
电商与市场团队每天要为大量 SKU 产出营销图,覆盖天猫、淘宝的主图商详和抖音、小红书的投放素材,过去全靠设计同学在 PS 里从零做——一张图从找参考、抠图、合成到调色,链路长、产能有限,遇到大促根本排不过来。
团队也试过直接上 AI 生图,但效率并没有明显改善。业务同学并不是不会写 prompt,而是很难一次就写出足够高质量的 prompt:要让模型稳定产出符合品牌规范的画面,得反复试、反复调,时间照样耗在里面。
所以这个 Agent 要解决的是时间问题:把”从零设计一张图”和”反复试 prompt”这两段重活都收进流程里,业务同学只填几个策划关键词和输出比例,产出直接对齐商用投放标准。
技术: 渠道不是一个模板打天下。主图商详服务转化、媒介投放服务注意力,两类从创意方向到质检标准各配一套。
02 能力边界
有四类工作我明确没有交给模型。
图内文字 — 图像模型渲染文字会出错字、崩笔画,甚至编出伪品牌标识,这在商用图里是事故,所以文字走独立图层渲染。
真实电池 — 正负极方向、型号、品牌印刷错一个就废,模型只负责生成留好空位的场景,电池从素材库取真实产品图合成。
修改决策 — 模型只读图给候选建议,选哪条由人定。
合规终审与精修 — 保留人的判断。
技术: 模型按环节分配。创意方向这类文本推理走 Qwen(qwen3.7-max);出图的三个环节——背景图生成、修改出图、组件合成——都走 OpenAI gpt-image-2;读图的环节(修改前的读图提方案、以及质检打分)用 Qwen3.5-Omni 多模态模型。每类任务各维护一组带优先级的候选模型,遇限流或模型不可用自动降级到下一个候选,所有调用统一走公司中转站。
03 工作流
用户在表单里填的是业务语言,不是 prompt:品牌、投放渠道(电商主图商详 / 媒介投放)、目标人群、使用场景、关键用电器、主推卖点、输出比例,另有两个开关——画面是否出现人物、是否留出空电池仓。
一次真实输入大致长这样:人群「母婴人群」、场景「家庭储备」、关键用电器「遥控器、玩具」、卖点「持久耐用、防漏液」、比例 1:1。
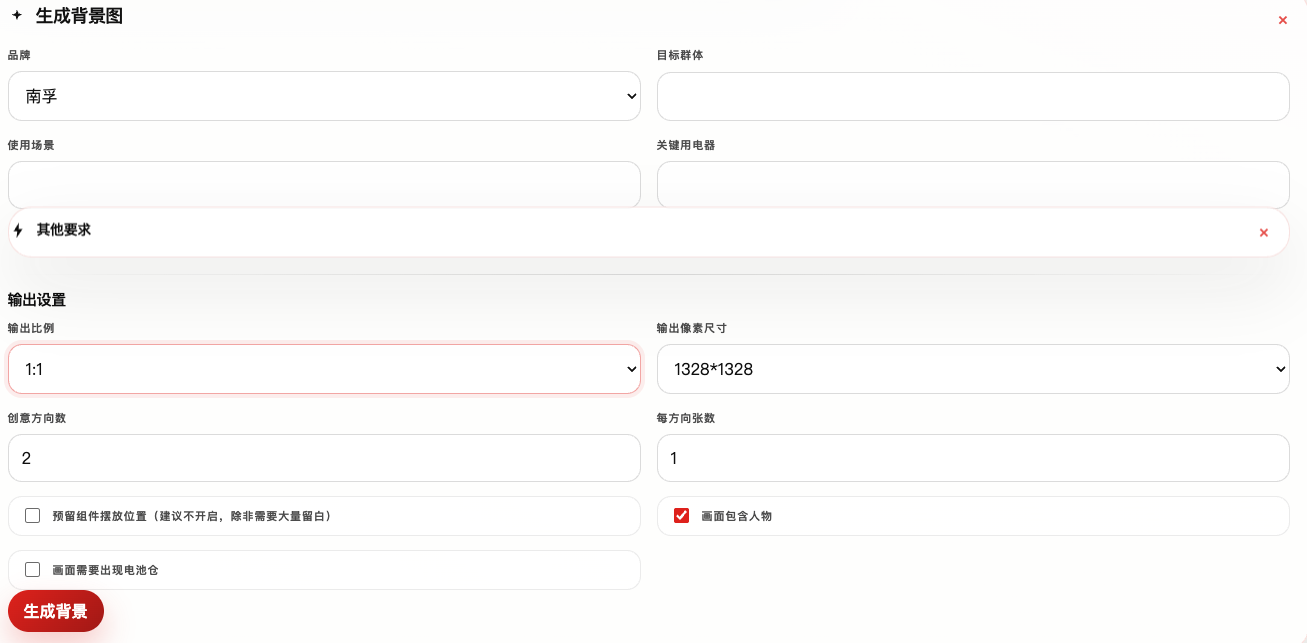
第一步 · 创意方向生成。 模型把这些关键词扩展成若干条结构化创意方向,每条都要填满固定字段:视觉主题、主色调、场景元素、构图方式、空间预留、适用渠道、风险点。正因为字段固定,系统可以按字段自动拼装出图 prompt,用户全程不用碰 prompt。
第二步 · 背景图生成。 按选定方向产出候选背景图。此时画面里只有场景,不含文字、Logo 和真实电池,这些留给后面的确定性环节。
第三步 · 修改(human-in-the-loop)。 分三小步:模型先读图,结合用户用口语提出的不满意处,判断画面里实际可改的地方;接着给出几条具体的修改方案供用户挑选;用户选定其中一条后,系统才按这条方案出图。模型负责看图和提方案,决定权始终在用户手里。
第四步 · 组件合成。 把电池体、Logo、文案、包装合成进画面。关键在于这些组件用的是素材库里的真实素材图,而不是让模型自己画——品牌标识、包装文字、电池的型号与正负极方向都以真实素材为准,不会被模型抽象、变形或凭空编造,也避免组件被误用、摆错。
四步之间用 LangChain 编排成一条完整链路,状态贯穿始终,形成可重复、可追溯的稳定出图流程。
技术: 按任务类型(文本 / 读图 / 生图 / 改图)分别维护候选模型,遇限流或模型不可用自动降级到下一个候选;每步产物落盘可回溯。
04 Prompt 工程
System prompt 做了两套:一套给南孚碱性电池,一套给传应纽扣电池。 这两个子品牌几乎没有共同点——南孚面向家庭日用电器(遥控器、玩具、血压计),要的是温暖生活感,明确禁用黑金和科技风;传应是石墨烯纽扣电池,主场景是车钥匙、定位追踪器、血糖仪、夜钓鱼漂,要的恰恰是黑金配色和科技质感。共用一套 prompt 必然串味,所以按品牌切换到两套独立规则集。
| 南孚(碱性电池) | 传应(纽扣电池) | |
|---|---|---|
| 场景 | 家庭日用电器 | 车钥匙 / 精密设备 / 户外垂钓 |
| 人群 | 家庭、母婴 | 车主、健康管理、户外爱好者 |
| 调性 | 温暖生活感 | 科技专业感 |
| 禁区 | 黑金、科技风 | 过度赛博、伪科技特效 |
两套 prompt 的骨架一致,都由这几块组成:业务范围(只允许该品牌真实的使用场景,必须点明具体设备、动作和人群,禁止泛化成”高级感背景”这类通用电商图)、渠道差异(电商主图商详重转化,要产品清晰可信;站外信息流重注意力,要场景和情绪;小红书抖音重真实生活感)、品牌调性(两套的核心分歧所在)、构图与留白(背景先行,必须为后续要合成的电池、包装、Logo、文案预留位置,画面不能太满)、硬性禁令(不得生成伪 Logo、伪文字、伪包装)、低质规避(畸形结构、乱码屏幕、不合理电池仓、虚假反光等列成清单排除)。
在此之上,用户侧的几个开关会直接改写出图 prompt:是否出现人物(不要人物时会显式穷举禁止人像及手、剪影等局部,改用陈设与光影体现生活气息)、是否留出空电池仓(要求用电器带一个打开、空置、比例合理的电池仓,供后续合成真实电池)、组件预留位置与输出比例。
Prompt 迭代过几轮,主线是持续把模型做不稳的东西挪出去——图里的文字、真实电池最终都不由模型生成,prompt 只负责模型能稳定做好的部分:场景、构图、氛围和留白。
05 评测体系
质检维度和市场部、电商品牌团队对齐后定为五维:背景、主体、文字、光影、版式。核心设计是每个维度下的问题都分了 severe 和 minor 两档,走不同的拒绝逻辑:
severe 一票否决 — 命中任一条,该维直接判 Risky。severe 收的是会出事的硬伤:伪品牌标识、竞品 Logo 出现、电池正负极错误、产品逻辑错误、文字崩坏。
minor 累积降级 — 单条不拦,累计到阈值才降级。某维 minor 累计 3 条判 Risky,1–2 条降为 Acceptable。收的是画面杂乱、留白过多、色彩违和这类不致命问题。
单维等级再映射成分数(Excellent=2 / Acceptable=1 / Risky=0),五维取平均得总分判总级:总分 ≥1.5 且无 Risky 维为 Excellent,总分 <0.75 或出现 ≥2 个 Risky 维为 Risky。主图商详和媒介投放各一套 rubric,同一个问题在两个渠道的严重度不同。
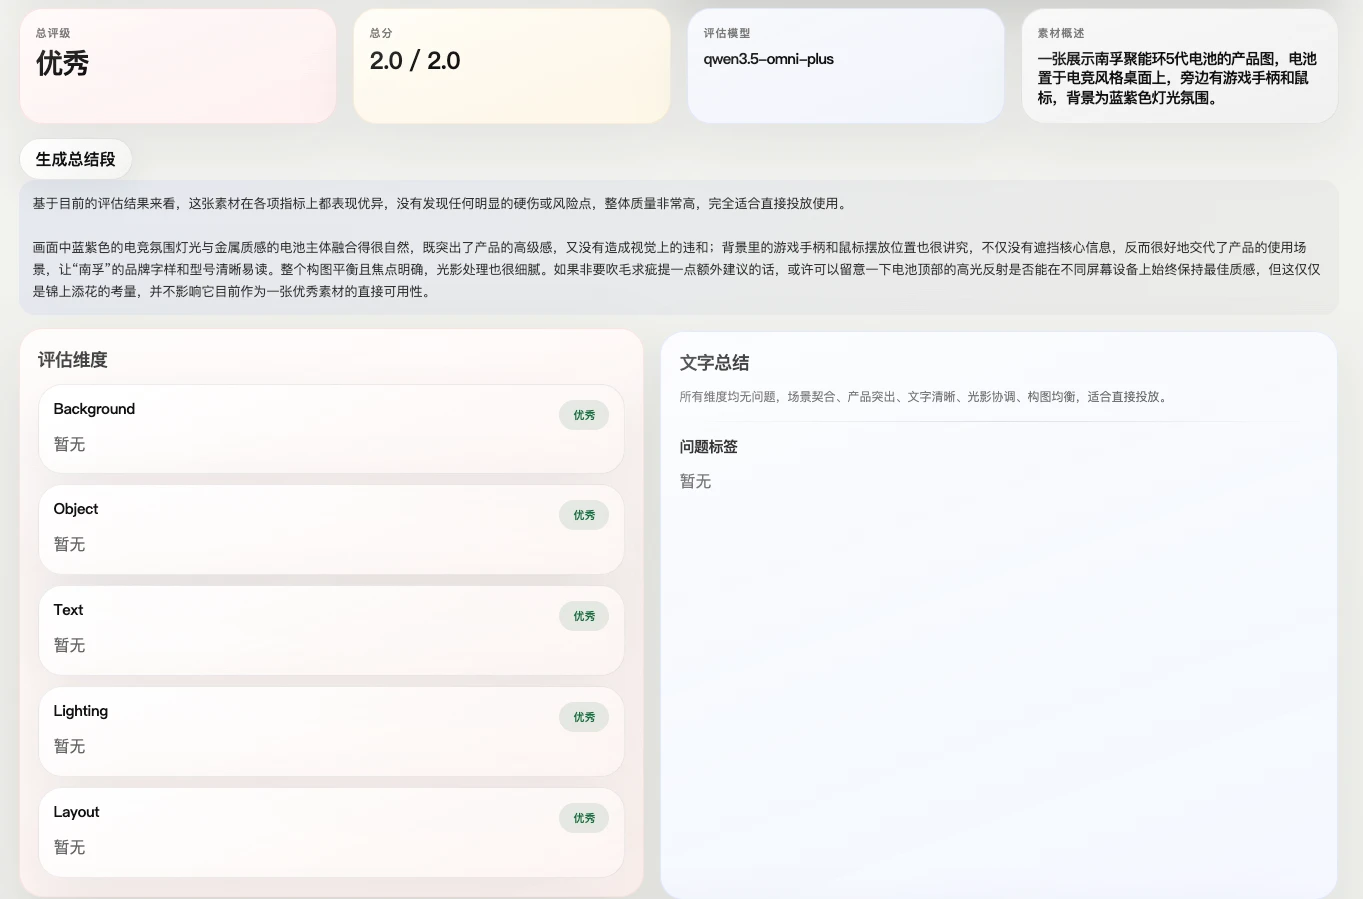
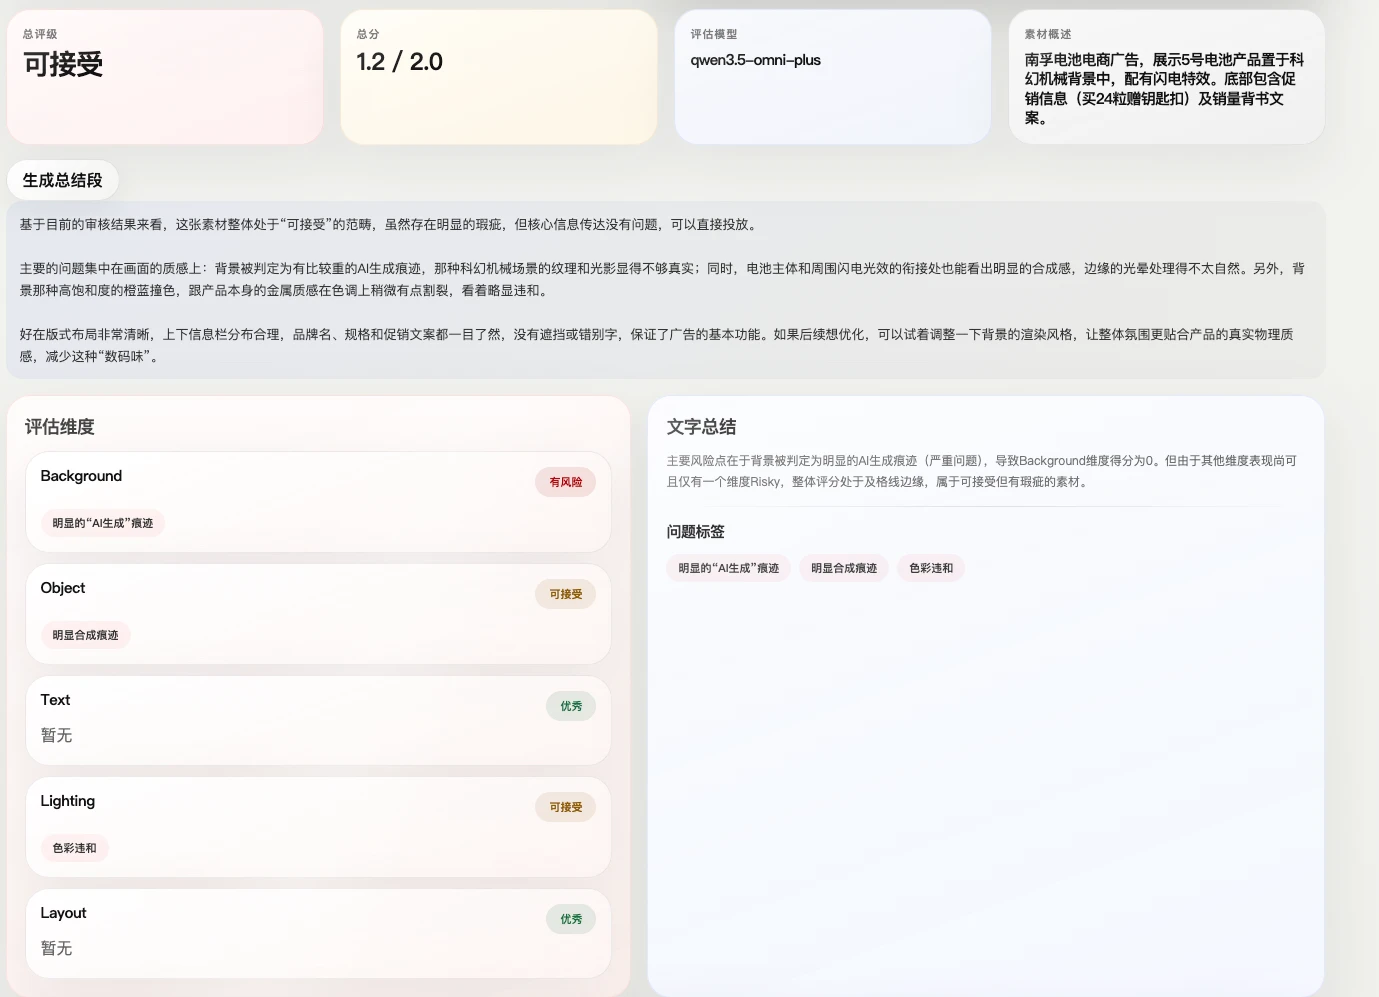
技术: 多模态模型读图后输出结构化结果(每维等级 + 分数 + 命中的问题标签),代码侧再做校验兜底,等级异常一律按 Risky 处理;五个维度并行评估。
06 落地与成效
平台与集团的统一素材库完成了打通,跑通三类数据往来:
取 — 组件合成时直接从素材库拉取真实的电池体、Logo、包装与卖点文案,保证合成进画面的都是权威素材。
存 — 用户选定的终稿连同生成上下文(人群、场景、投放用途、关键用电器、卖点、比例)和这张图的质检结果一并回存,并记录它来自哪张素材,建立素材血缘。只存终稿、不存中间稿,避免污染素材库。
迭代 — 已回存的成品可以被重新取回,进入修改环节继续调整,改完作为新版本存回,而不是覆盖原图。
平台侧还做了管理员统一建号、工作区隔离、作品归属与审计记录,支持多人并行作业、互不干扰;系统容器化后部署到腾讯云。
项目 7 月上线,目前已在市场团队和电商团队投入使用。据团队反馈,约 70% 的素材生产过程已由 Agent 承担,大幅减少了他们的工作量。预计三季度起开始整体投放 AIGC 图片,用于对外宣传。
技术: 素材库以 API Key 换取短期 token 访问,按用户隔离;缩略图由后端代理转发,前端不直连素材库。账号、作品归属与审计记录落库,运行产物按用户与会话隔离。